Trí tuệ nhân tạo đã rời phòng thí nghiệm để đi vào phần mềm hằng ngày. Bộ phận chăm sóc khách hàng dùng nó để soạn câu trả lời, phòng tài chính dùng nó để đọc hóa đơn, còn lập trình viên viết code cùng trợ lý AI. Thế nhưng nhiều dự án AI vẫn dậm chân tại chỗ sau một bản demo ấn tượng. Điều phân biệt dự án được triển khai với dự án bị bỏ dở hiếm khi là mô hình. Đó là một bài toán rõ ràng, dữ liệu tốt và kỷ luật kỹ thuật.
Bài viết này giải thích các khái niệm cốt lõi bằng ngôn ngữ dễ hiểu, chỉ ra nơi AI đang tạo ra giá trị ngay lúc này, và hướng dẫn hai kỹ thuật thực tế: huấn luyện một mô hình machine learning cổ điển và neo một mô hình ngôn ngữ lớn vào dữ liệu của chính bạn.
AI, machine learning và AI tạo sinh: làm rõ các thuật ngữ
Các từ này thường được dùng thay thế cho nhau, nhưng chúng mô tả những tầng khác nhau của cùng một lĩnh vực:
- Trí tuệ nhân tạo (AI) là thuật ngữ bao trùm cho phần mềm thực hiện những việc ta gắn với trí thông minh của con người: hiểu ngôn ngữ, nhận diện hình ảnh, ra quyết định.
- Machine learning (ML) là hướng tiếp cận AI thành công nhất. Thay vì viết luật bằng tay, bạn cho hệ thống xem các ví dụ và nó học các luật dưới dạng mẫu thống kê.
- Deep learning là machine learning với mạng nơ-ron nhiều tầng. Nó vận hành nhận dạng giọng nói, thị giác máy tính và các mô hình ngôn ngữ hiện đại.
- AI tạo sinh dùng các mô hình deep learning rất lớn, như mô hình ngôn ngữ lớn (LLM), để tạo ra văn bản, hình ảnh, âm thanh hoặc mã nguồn mới thay vì chỉ phân loại dữ liệu có sẵn.
Biết một bài toán thuộc tầng nào là điều quan trọng. Dự đoán khách hàng nào sắp hủy dịch vụ là bài toán ML cổ điển mà một mô hình nhỏ, rẻ xử lý tốt. Tóm tắt phiếu hỗ trợ hay trả lời câu hỏi về tài liệu của bạn là bài toán của AI tạo sinh.
AI đang tạo ra giá trị ở đâu
Những ứng dụng thành công nhất có chung một khuôn mẫu: một công việc lặp lại với khối lượng lớn, nơi một câu trả lời đủ tốt tiết kiệm được thời gian thực sự, và con người có thể xem lại kết quả khi cần.
- Chăm sóc khách hàng: phân loại và chuyển phiếu hỗ trợ, gợi ý câu trả lời từ cơ sở tri thức, và tóm tắt các cuộc hội thoại dài cho nhân viên tiếp theo.
- Xử lý tài liệu: trích xuất thông tin từ hóa đơn, biên lai, hợp đồng và giấy tờ tùy thân, thay thế việc nhập liệu thủ công.
- Dự báo: dự đoán nhu cầu, tồn kho, dòng tiền hoặc nhu cầu nhân sự từ dữ liệu lịch sử.
- Tìm kiếm và gợi ý: tìm kiếm ngữ nghĩa hiểu ý nghĩa thay vì từ khóa chính xác, và gợi ý sản phẩm dựa trên hành vi.
- Phát hiện bất thường: cảnh báo giao dịch lạ, máy móc sắp hỏng hoặc đăng nhập đáng ngờ trước khi chúng thành sự cố.
- Phát triển phần mềm: gợi ý code, sinh test và trợ lý review code giúp tăng tốc các công việc kỹ thuật thường ngày.
Một mô hình machine learning thực sự học như thế nào
Phần lớn ML trong doanh nghiệp là học có giám sát: bạn thu thập các ví dụ lịch sử đã biết đáp án (gọi là nhãn) và huấn luyện mô hình dự đoán nhãn đó cho các trường hợp mới. Để dự đoán khách hàng rời bỏ, mỗi dòng là một khách hàng, các cột là đặc trưng như thời gian sử dụng và chi tiêu hằng tháng, còn nhãn là việc họ có rời đi hay không.
Kỷ luật then chốt là đánh giá. Bạn giữ lại một phần dữ liệu mà mô hình không bao giờ thấy khi huấn luyện, và chỉ đo hiệu quả trên tập kiểm tra đó. Một mô hình đạt điểm tuyệt đối trên dữ liệu huấn luyện nhưng kém trên dữ liệu mới đã bị overfitting: nó học thuộc ví dụ thay vì học quy luật.
Đây là một mô hình cơ sở hoàn chỉnh, sát thực tế, viết bằng Python với scikit-learn:
import pandas as pd
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report
from sklearn.model_selection import train_test_split

df = pd.read_csv("customers.csv")
features = ["tenure_months", "monthly_spend", "support_tickets", "logins_last_30d"]
X, y = df[features], df["churned"]

# Keep 20% aside for an honest evaluation; stratify keeps the churn ratio equal in both sets
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, stratify=y, random_state=42
)

model = RandomForestClassifier(n_estimators=300, class_weight="balanced", random_state=42)
model.fit(X_train, y_train)

print(classification_report(y_test, model.predict(X_test)))
Đừng chỉ nhìn độ chính xác tổng thể. Nếu chỉ 5% khách hàng rời bỏ, một mô hình luôn dự đoán "ở lại" sẽ chính xác 95% mà hoàn toàn vô dụng. Precision (bao nhiêu khách hàng bị gắn cờ thực sự rời đi) và recall (bắt được bao nhiêu người rời đi) cho bạn biết mô hình có đáng để hành động theo hay không.
Hai kiểu học khác cũng đáng biết. Học không giám sát tìm cấu trúc trong dữ liệu không có nhãn, chẳng hạn chia khách hàng thành các phân khúc. Học tăng cường học qua thử và thưởng, được dùng trong robot, trò chơi và để tinh chỉnh mô hình ngôn ngữ.
Xây dựng với mô hình ngôn ngữ lớn
Mô hình ngôn ngữ lớn có năng lực đáng kinh ngạc ngay khi dùng, nhưng chúng chỉ biết những gì có trong dữ liệu huấn luyện, và có thể tự tin đưa ra câu trả lời sai, hiện tượng gọi là hallucination (ảo giác). Với doanh nghiệp, mẫu đáng tin cậy nhất là retrieval-augmented generation (RAG): thay vì tin vào trí nhớ của mô hình, bạn truy xuất các dữ kiện liên quan từ dữ liệu của mình và yêu cầu mô hình chỉ trả lời dựa trên những dữ kiện đó.
- 01Lập chỉ mục: chia tài liệu thành các đoạn, chuyển mỗi đoạn thành một embedding (vector thể hiện ý nghĩa của nó) và lưu các vector vào một chỉ mục vector.
- 02Truy xuất: khi có câu hỏi, chuyển nó thành embedding theo cùng cách và lấy các đoạn có vector gần nhất.
- 03Sinh câu trả lời: gửi câu hỏi cùng các đoạn đó tới LLM, kèm hướng dẫn chỉ trả lời từ ngữ cảnh được cung cấp và trích dẫn nguồn.
- 04Đánh giá: kiểm tra hệ thống với một bộ câu hỏi thực tế đã biết đáp án, và theo dõi độ chính xác khi bạn thay đổi prompt, mô hình hoặc dữ liệu.
Một bản phác thảo không phụ thuộc nhà cung cấp bằng TypeScript trông như sau. embed, vectorStore và llm đại diện cho mô hình embedding, cơ sở dữ liệu vector và LLM mà bạn sử dụng:
type Passage = { id: string; text: string; source: string }

export async function answerQuestion(question: string): Promise<string> {
  // 1. Find the passages whose meaning is closest to the question
  const queryVector = await embed(question)
  const passages: Passage[] = await vectorStore.search(queryVector, { topK: 5 })

  // 2. Ground the model in those passages and require citations
  const context = passages.map((passage, index) => `[${index + 1}] (${passage.source}) ${passage.text}`).join('\n\n')

  const prompt = [
    'Answer the question using only the context below. Cite sources like [1].',
    'If the context does not contain the answer, say that you do not know.',
    `Context:\n${context}`,
    `Question: ${question}`,
  ].join('\n\n')

  return llm.generate({ prompt, temperature: 0.2 })
}
RAG giữ câu trả lời luôn cập nhật (chỉ cần cập nhật chỉ mục, không phải mô hình), giúp chúng có thể kiểm chứng nhờ trích dẫn, và giữ dữ liệu nhạy cảm trong hệ thống bạn kiểm soát. Tinh chỉnh (fine-tuning) mô hình thường là bước thứ hai, dùng để dạy văn phong hoặc định dạng đặc thù, không phải để dạy kiến thức.
Một mô hình chỉ tốt bằng dữ liệu và cách đánh giá đứng sau nó. Phần lớn công sức của một dự án AI thành công nằm ở trước và sau mô hình.
Những rủi ro cần quản lý ngay từ đầu
- Ảo giác: neo câu trả lời vào dữ liệu được truy xuất, yêu cầu trích dẫn, và giữ con người trong vòng kiểm duyệt với các quyết định quan trọng.
- Thiên lệch: mô hình học các mẫu từ dữ liệu lịch sử, kể cả những mẫu bất công. Hãy kiểm tra hiệu quả trên từng nhóm khách hàng, không chỉ con số trung bình.
- Quyền riêng tư: biết rõ dữ liệu nào bạn gửi tới API bên thứ ba, loại bỏ dữ liệu cá nhân khi có thể, và kiểm tra điều khoản lưu trữ dữ liệu của nhà cung cấp.
- Bảo mật: coi đầu ra của mô hình là dữ liệu không đáng tin. Prompt injection ẩn trong một tài liệu hoặc trang web có thể tìm cách khiến mô hình bỏ qua chỉ dẫn của bạn.
- Chi phí và độ trễ: mô hình lớn chậm hơn và đắt hơn cho mỗi yêu cầu. Hãy chuyển các tác vụ đơn giản sang mô hình nhỏ hơn và lưu đệm các câu trả lời lặp lại.
- Quy định pháp lý: các quy định như Đạo luật AI của EU đặt ra nghĩa vụ cho các ứng dụng rủi ro cao. Hãy ghi lại hệ thống của bạn làm gì và đã được kiểm thử ra sao.
Lộ trình thực tế cho dự án AI đầu tiên
- 01Chọn một bài toán đo lường được, chẳng hạn "giảm 50% thời gian nhập hóa đơn", chứ không phải "ứng dụng AI".
- 02Rà soát dữ liệu. Dữ liệu có sẵn, đã gắn nhãn, còn mới và được phép sử dụng hợp pháp không? Thiếu dữ liệu là lý do phổ biến nhất khiến dự án bị đình trệ.
- 03Xây một phương án cơ sở đơn giản bằng luật hoặc mô hình cơ bản. Giải pháp AI phải vượt qua nó mới xứng đáng với chi phí.
- 04Làm nguyên mẫu với mô hình và API có sẵn trước khi huấn luyện bất cứ thứ gì riêng. Bạn học nhanh hơn và rẻ hơn.
- 05Đánh giá trên dữ liệu giữ lại và với người dùng thật, dùng precision và recall phù hợp với trường hợp của bạn.
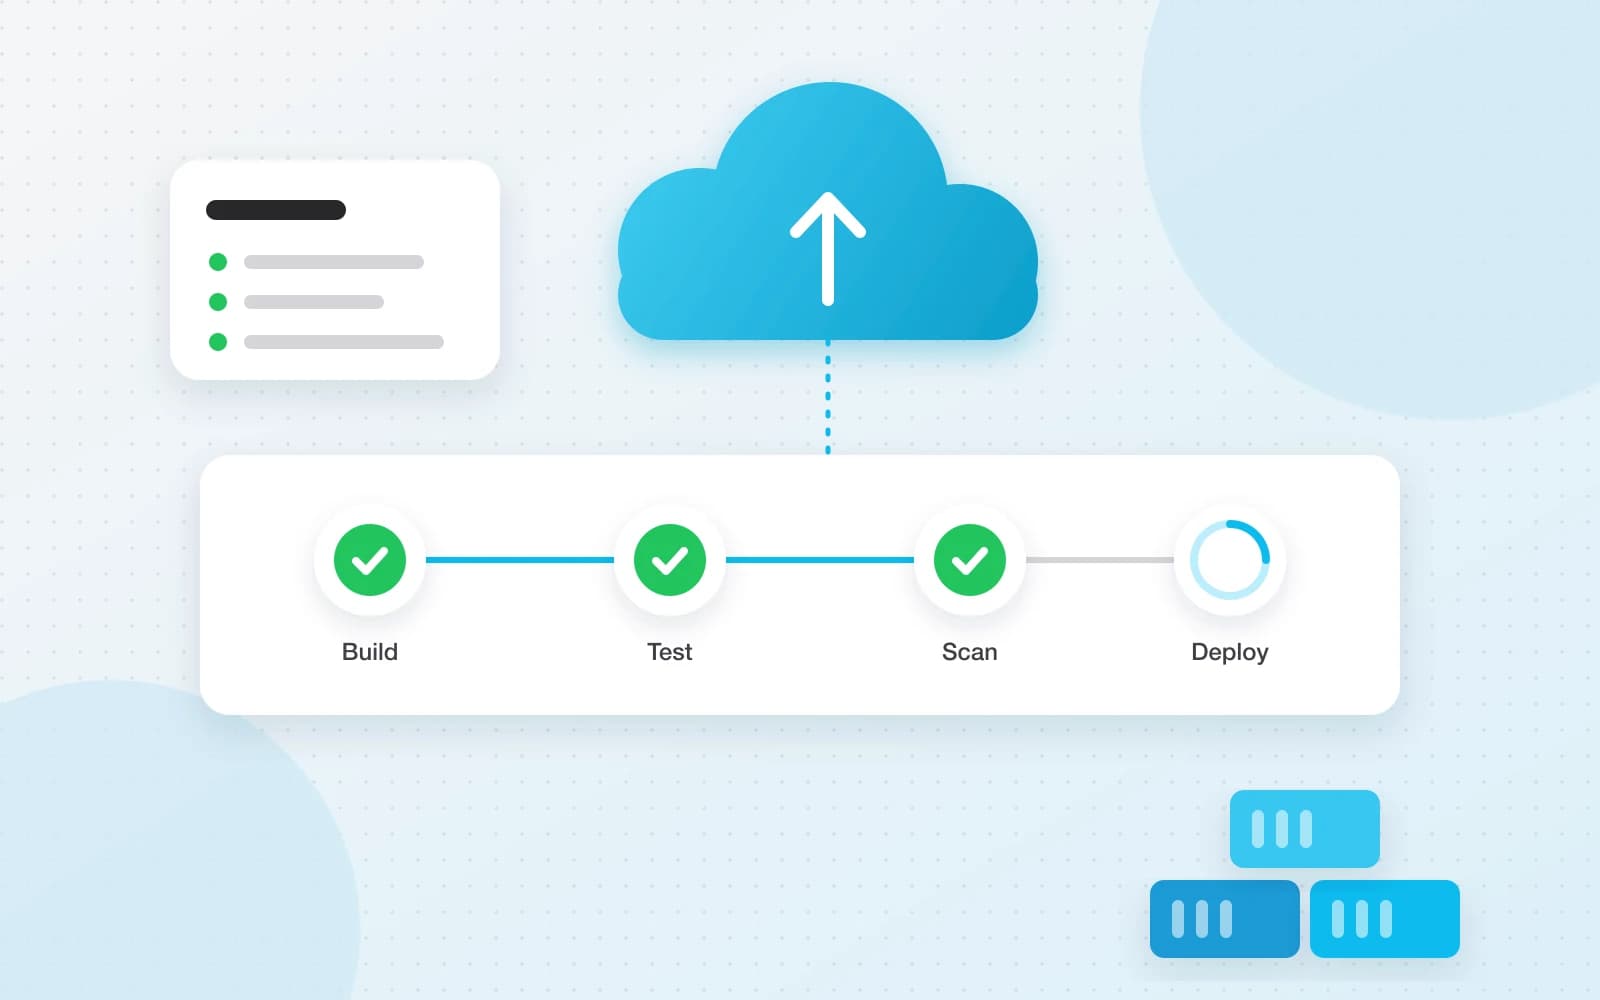
- 06Triển khai kèm giám sát và phương án dự phòng. Ghi log đầu vào và đầu ra, theo dõi sự trôi dạt dữ liệu, và cho phép con người sửa lỗi hệ thống.
- 07Lặp lại. Dùng những chỉnh sửa của con người làm dữ liệu huấn luyện và đánh giá mới.
Những điểm chính
- Chọn kỹ thuật phù hợp với bài toán: ML cổ điển cho dự đoán trên dữ liệu có cấu trúc, AI tạo sinh cho ngôn ngữ và nội dung.
- Luôn đánh giá trên dữ liệu mô hình chưa từng thấy, và chọn chỉ số phản ánh chi phí kinh doanh của sai sót.
- Retrieval-augmented generation là cách đáng tin cậy nhất để dùng LLM với tri thức của riêng bạn.
- Lên kế hoạch cho quyền riêng tư, bảo mật, thiên lệch và chi phí ngay từ đầu, không phải sau khi ra mắt.
Kết luận
AI giờ đây là một công cụ kỹ thuật thực tế chứ không còn là dự án viển vông. Những đội thành công bắt đầu nhỏ, đo lường trung thực và coi mô hình là một thành phần trong một hệ thống được thiết kế tốt, với dữ liệu sạch đầu vào, giám sát xung quanh và con người xem xét những quyết định quan trọng. Hãy chọn một quy trình lặp lại gây nhiều phiền toái, chứng minh giá trị ở đó, rồi xây tiếp trên nền tảng ấy.
Đọc thêm
- #Artificial Intelligence
- #LLM
- #Machine Learning
- #Python